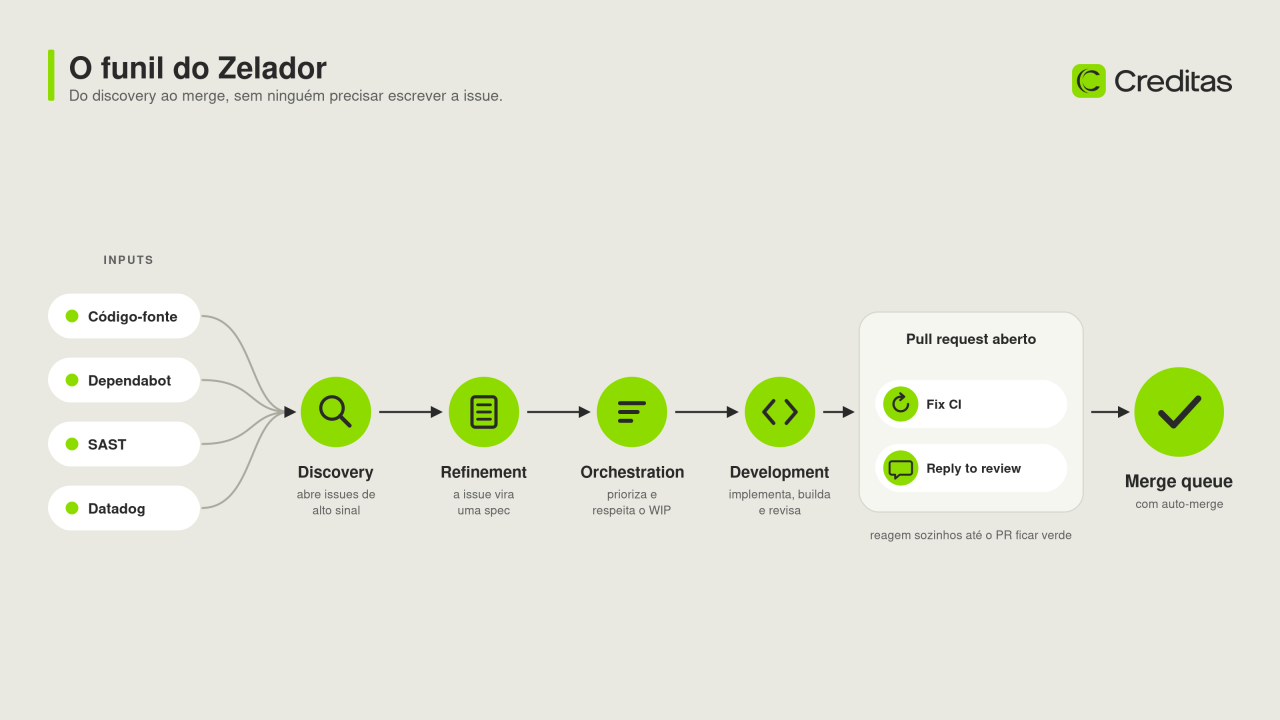
<?xml version="1.0" encoding="utf-8"?><feed xmlns="http://www.w3.org/2005/Atom" xml:lang="pt-BR"><generator uri="https://jekyllrb.com/" version="3.10.0">Jekyll</generator><link href="https://aureliosaraiva.github.io/feed.xml" rel="self" type="application/atom+xml" /><link href="https://aureliosaraiva.github.io/" rel="alternate" type="text/html" hreflang="pt-BR" /><updated>2026-11-03T18:13:21+01:00</updated><id>https://aureliosaraiva.github.io/feed.xml</id><title type="html">Aurélio Saraiva</title><subtitle>Distinguished Engineer na Creditas. Escrevo sobre arquitetura de software, engenharia e IA aplicada ao desenvolvimento.</subtitle><author><name>Aurélio Saraiva</name><email>aurelio.saraiva@creditas.com.br</email></author><entry><title type="html">O Zelador: como a Creditas colocou um agente de IA para cuidar do que ninguém prioriza</title><link href="https://aureliosaraiva.github.io/blog/2026/10/o-zelador-agente-de-manutencao/" rel="alternate" type="text/html" title="O Zelador: como a Creditas colocou um agente de IA para cuidar do que ninguém prioriza" /><published>2026-10-13T00:00:00+02:00</published><updated>2026-10-13T00:00:00+02:00</updated><id>https://aureliosaraiva.github.io/blog/2026/10/o-zelador-agente-de-manutencao</id><content type="html" xml:base="https://aureliosaraiva.github.io/blog/2026/10/o-zelador-agente-de-manutencao/"><![CDATA[<p><img src="/assets/img/posts/zelador-capa.png" alt="O funil do Zelador, do discovery ao merge. Código-fonte, Dependabot, SAST e Datadog alimentam o Discovery, que abre issues de alto sinal. O Refinement transforma cada issue numa spec. A Orchestration prioriza respeitando o WIP. O Development implementa, builda e revisa. Com o pull request aberto, dois fluxos reagem sozinhos até ele ficar verde: um conserta o CI, outro responde ao review. No fim, a merge queue faz o auto-merge." /></p>

<p><em>Publicado originalmente no <a href="https://www.linkedin.com/pulse/o-zelador-como-creditas-colocou-um-agente-de-ia-para-cuidar-saraiva-8bxrf/">LinkedIn</a> em 13/10/2026.</em></p>

<p>Todo time de tecnologia tem débito técnico, e todo mundo sabe que ele existe. Vulnerabilidade nova aparece toda semana. Biblioteca desatualizada acumula. Refatoração adiada vira comentário em code review que ninguém volta para ler. Cenário crítico sem teste fica sem teste até o dia em que quebra em produção.</p>

<p>Nada disso acontece por ignorância. Acontece porque manutenção disputa capacity com iniciativa de negócio, e perde, quase sempre, e com razão aparente, porque o custo de não fazer só aparece depois. É uma questão de priorização, não de compreensão.</p>

<p>O que muda a escala do problema é o crescimento. Com 10 serviços, dá para carregar o débito técnico na cabeça de quem os mantém. Com 500, não dá. O backlog de manutenção deixa de ser uma lista e vira um passivo distribuído, invisível, que só ganha prioridade quando já virou incidente.</p>

<p><strong>Minha tese é que esse problema não se resolve priorizando melhor. Ele se resolve tirando o trabalho da fila onde ele sempre perde.</strong> Um agente autônomo não disputa sprint, não é realocado para a entrega do trimestre e não precisa convencer ninguém de que atualizar o Node ou Kotlin é mais importante que a próxima feature. Ele opera fora dessa disputa.</p>

<p>Foi essa aposta que virou o Zelador, o agente de manutenção que roda em alguns repositórios da Creditas. O nome é o que ele faz: zelador é quem mantém o condomínio funcionando, conserta o que quebra e melhora o que ninguém repara, sem que ninguém precise pedir.</p>

<p>Abaixo está como ele foi construído e o que quatro semanas de funcionamento mostraram.</p>

<h2 id="o-problema-estava-claro-o-como-não">O problema estava claro; o como, não</h2>

<p>Eu sabia o que precisava ser feito. A dificuldade inteira estava na execução, e ela se resumia a três restrições que eliminaram quase todas as alternativas.</p>

<p><strong>A primeira era escala sem infraestrutura nova.</strong> Se a ideia é atender a empresa toda, não pode depender da máquina do desenvolvedor ligada rodando agente. E não pode ser trabalho local: um agente que só existe no notebook de quem o instalou é uma ferramenta pessoal, não uma capacidade de plataforma.</p>

<p><strong>A segunda era o custo de operar isso.</strong> Imagine 50 pull requests sendo produzidos ao mesmo tempo, cada um com um build de Kotlin e Gradle rodando junto. Que tamanho tem essa máquina? Quanta CPU e memória eu reservo, e para qual pico? Dava para escalar pods sob demanda, claro. Mas gerenciar essa infraestrutura era exatamente o trabalho que eu não queria assumir no começo de um projeto cujo valor ainda está por provar.</p>

<p><strong>A terceira era não ficar preso a um fornecedor.</strong> Eu queria liberdade para trocar de modelo sem reescrever a plataforma.</p>

<p>Foi procurando por essas três restrições ao mesmo tempo que encontrei o <a href="https://github.com/All-Hands-AI/OpenHands">OpenHands</a>, um harness de desenvolvimento open source. Ele conecta em AWS Bedrock, que é a infraestrutura de modelo que a Creditas já usa, e aceita proxy reverso para um LiteLLM customizado quando for necessário trocar de provedor. Resolve a terceira restrição por padrão.</p>

<p>E resolve a primeira e a segunda por um detalhe que parecia menor: o OpenHands roda em GitHub Actions. Isso significa que a plataforma não tem servidor. Cada execução do agente é um job efêmero, que nasce quando há trabalho e morre quando termina. Não há máquina ociosa esperando pico, não há dimensionamento a acertar, não há cluster a manter. E quando o volume justificar infraestrutura própria, o mesmo harness roda em servidor dedicado sem reescrita.</p>

<p>Para quem adota, a consequência prática é que não se instala nada. O engenheiro interage pelo GitHub: abre issue, aplica label, revisa o PR que o agente abriu.</p>

<h2 id="um-agente-de-manutenção-precisa-fabricar-o-próprio-backlog">Um agente de manutenção precisa fabricar o próprio backlog</h2>

<p>Colocar um agente para executar tarefas de manutenção resolve metade do problema. A outra metade é que ninguém escreveu essas tarefas.</p>

<p>Esse é o ponto que eu subestimei no começo. Catalogar o que precisa ser feito é tão difícil quanto fazer. Se o Zelador dependesse de alguém abrir as issues, ele herdaria exatamente a fila que já não é priorizada, e o projeto inteiro teria sido um jeito caro de não resolver nada.</p>

<p>Por isso uma premissa virou requisito: <strong>o agente alimenta o próprio backlog.</strong> Ele consome sinais que já existem na empresa e os transforma em trabalho executável.</p>

<table>
  <thead>
    <tr>
      <th>Fonte</th>
      <th>O que ela entrega</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>Código-fonte</td>
      <td>Achados de teste faltando, refatoração pendente, problema estrutural</td>
    </tr>
    <tr>
      <td>Dependabot</td>
      <td>Biblioteca desatualizada e dependência com vulnerabilidade conhecida</td>
    </tr>
    <tr>
      <td>Semgrep</td>
      <td>Findings de segurança da análise estática</td>
    </tr>
    <tr>
      <td>Datadog</td>
      <td>Erro recorrente em log e trace de produção, correlacionado com o código</td>
    </tr>
  </tbody>
</table>

<p>A fonte do Datadog é a que menos se parece com as outras, e é a mais interessante: ela não olha para o código, olha para o comportamento em produção. O agente pega o erro que está acontecendo agora, correlaciona com o trecho de código que o causa e abre issue quando a correção é local e mecânica. É o caminho mais curto entre um erro que ninguém abriu ticket e um PR que o conserta.</p>

<h2 id="o-funil-e-por-que-a-máquina-de-estados-vive-nas-labels">O funil, e por que a máquina de estados vive nas labels</h2>

<p>O Zelador é um GitHub App mais um conjunto de workflows reutilizáveis. Não há banco de dados de estado, não há painel de controle próprio, não há um segundo lugar para consultar. <strong>O estado de cada trabalho vive na label da issue</strong>, e a transição entre etapas acontece por label.</p>

<p>Essa decisão não é estética. Ela significa que qualquer pessoa entende o que o agente está fazendo olhando para o GitHub, com a interface que já usa, sem aprender ferramenta nova. E significa que intervir é aplicar uma label.</p>

<p>O fluxo tem cinco momentos:</p>

<p><strong>Descoberta.</strong> Um scan somente-leitura do repositório, mais a leitura do Datadog quando habilitada, abre issues para os achados de alto sinal. Há teto diário para não inundar ninguém.</p>

<p><strong>Refino.</strong> O agente investiga o repositório e reescreve a issue como uma spec pronta: contexto, arquivos afetados, passos de execução ordenados, critérios de aceite, o que está fora de escopo. Achado que a triagem julga inválido é fechado com o motivo escrito, em vez de ficar apodrecendo no backlog.</p>

<p>O plano ficar dentro da issue é deliberado, e é a parte do desenho de que mais gosto. Ele é revisável por uma pessoa antes de existir uma linha de código. Em repositório crítico, é exatamente aí que a liberação humana entra. E ele sobrevive ao contexto do agente de desenvolvimento, que relê a issue em vez de confiar na própria memória.</p>

<p><strong>Orquestração.</strong> Um scheduler promove issues prontas para execução respeitando prioridade, urgência e ordem de chegada, e segurando o limite de trabalho em curso. Ele também reconcilia o que travou: issue marcada como em execução, sem nada rodando e sem PR aberto, volta para a fila.</p>

<p><strong>Desenvolvimento.</strong> O agente executa o plano tarefa por tarefa, na ordem dada. Ele não planeja por conta própria e desvio precisa ser declarado. Cada tarefa passa por um ciclo de implementar, verificar com o comando de build do próprio repositório, revisar e corrigir, com teto de tentativas. Uma issue rende um commit e um PR, por mais tarefas que o plano tenha.</p>

<p><strong>Convergência.</strong> Depois do PR aberto, dois fluxos reagem sozinhos: um conserta CI vermelho, outro aplica sugestões de review e responde os comentários. Se a branch protection for satisfeita, o merge acontece pelo mecanismo nativo do GitHub.</p>

<p>Um detalhe que só aparece quando se opera: a execução é em série por repositório, de propósito, para não estourar o rate limit do Bedrock. O limite de PRs abertos e o paralelismo de execução são dimensões diferentes, e confundir as duas é o erro mais fácil de cometer aqui.</p>

<h2 id="o-que-o-agente-nunca-faz">O que o agente nunca faz</h2>

<p>Autonomia sem limite é um problema, não uma feature. Algumas proteções são parte do desenho e não dependem de configuração de quem adota:</p>

<ul>
  <li><strong>Não edita <code class="language-plaintext highlighter-rouge">.github/</code>.</strong> Nem workflow, nem action, nem <code class="language-plaintext highlighter-rouge">CODEOWNERS</code>. O agente não mexe nas regras que o governam.</li>
  <li><strong>Não faz commit nem push, e não chama a API do GitHub.</strong> O token fica escondido dele. Quem escreve no repositório é o pipeline determinístico, em Python e Bash, que não é o agente.</li>
  <li><strong>Não desabilita nem pula teste ou lint</strong>, e não afrouxa a configuração de build. O caminho mais curto para o verde está bloqueado.</li>
  <li><strong>Respeita os paths protegidos</strong> que cada repositório declara.</li>
  <li><strong>Tem teto de iterações e de budget por tarefa.</strong> Execução cara é interrompida, não descoberta na fatura.</li>
</ul>

<p>E todo trabalho é rastreável: os PRs carregam label de proveniência e os commits trazem os trailers que declaram que aquilo foi feito por IA, com qual ferramenta e com qual modelo.</p>

<h2 id="quatro-semanas-de-operação">Quatro semanas de operação</h2>

<p>Entre 22 de julho e 19 de agosto de 2026, o Zelador mergeou <strong>224 pull requests em diversos repositórios</strong>, de sete times diferentes.</p>

<p><strong>Volume não é o que importa aqui</strong>, e o motivo é simples. Mais código é passivo antes de ser ativo: o que se acrescenta também se mantém. Contagem de PR é a métrica mais fácil de inflar e a que menos diz.</p>

<p>O que importa é a composição. <strong>99% desses PRs são teste, correção de bug, refatoração ou segurança.</strong> Manutenção, quase por inteiro. Feature é resíduo, e é assim que tem que ser.</p>

<h3 id="sobre-comparar-o-agente-com-a-engenharia">Sobre comparar o agente com a engenharia</h3>

<p>Essa comparação pede cuidado, e o cuidado é o seguinte: <strong>não é uma comparação de produtividade, e não faria sentido que fosse.</strong></p>

<p>Um agente não participa de reunião, não faz descoberta de produto, não desenha solução com stakeholder, não negocia escopo e não carrega contexto de negócio. Ele executa uma fatia estreita de trabalho, escolhida de propósito para ser estreita. Ler o número de PRs dele ao lado do de uma pessoa compara coisas que não são a mesma.</p>

<p>A diferença real é de <strong>foco</strong>, não de velocidade. No mesmo período, pouco menos da metade do trabalho da engenharia foi manutenção, o que é exatamente o esperado de quem entrega roadmap e precisa escolher. A do agente foi quase toda. Ele não está acelerando o que já era feito; está cobrindo a faixa que a fila de prioridade não alcança.</p>

<p>Teste é o exemplo mais claro. É o trabalho que mais sofre com a disputa de capacity, porque o custo de não escrever aparece meses depois e em outro lugar. Que o agente escreva teste em quase todo repositório onde entra não é mérito dele sobre ninguém: é o efeito de existir uma fila onde esse trabalho não compete com prazo.</p>

<h3 id="onde-a-cadeia-fecha-ponta-a-ponta">Onde a cadeia fecha ponta a ponta</h3>

<p>Em um dos serviços dá para medir do esforço ao resultado. É o repositório em que o agente mais atuou, e nele <strong>a cobertura de teste saiu de 62% para 96,7% em quatro semanas</strong>, sobre uma suíte que antes era quase inexistente.</p>

<p>Isso sai da faixa de melhoria incremental. É criação de suíte de teste onde praticamente não havia uma. Nos demais repositórios o movimento é incremental, e em alguns não há instrumentação de cobertura para dizer coisa alguma.</p>

<h3 id="segurança">Segurança</h3>

<p>Nove PRs de segurança no período, todos rotulados e rastreáveis. A maior parte é atualização de dependência vulnerável, uma delas fechando dois CVEs nomeados. O restante é higiene: tratamento de erro e de log.</p>

<p>É uma categoria que, no período, não vinha sendo endereçada por nenhum outro caminho.</p>

<h2 id="o-gargalo-mudou-de-lugar">O gargalo mudou de lugar</h2>

<p>O dado que mais me interessa operacionalmente não é sobre o agente. É sobre nós.</p>

<p>O tempo entre a revisão e o merge dos PRs do agente ficou em 96 minutos, cerca de seis vezes o de um PR comum. Novos revisores entraram no período e a degradação parou, mas o patamar continua alto.</p>

<p>A leitura é direta. <strong>A geração deixou de ser o limite; a revisão virou o limite.</strong> A capacidade já existe e já foi paga. O que a destrava é ampliar o time que revisa, não aumentar o volume que o agente produz.</p>

<p>O efeito de segunda ordem é este: um agente que produz mais do que a empresa consegue revisar não está entregando valor, está transferindo trabalho de um lugar para outro. O número de PRs em aberto é o termômetro disso, e é por isso que existe um teto de trabalho em curso no desenho.</p>

<h2 id="conclusão">Conclusão</h2>

<p>O Zelador não é uma aposta de que IA escreve código melhor que gente. É uma aposta de que existe uma categoria de trabalho que toda empresa reconhece como necessária e nunca prioriza, e que essa categoria não precisa competir por atenção humana para ser feita.</p>

<p>O que sustenta o caso não é volume. É que a quase totalidade do que ele entregou é teste, correção, refatoração e segurança, a faixa que a fila não alcançava, e que, onde havia instrumentação para medir, o efeito apareceu.</p>

<p>Os próximos passos são de escala, não de invenção. Expandir o número de aplicações cobertas. Continuar aprendendo com o que cada repositório novo ensina, porque nenhum deles se parece com o anterior. E conectar novos estímulos externos: fontes de sinal que ainda não alimentam o backlog dele e que podem virar issue sem ninguém escrever uma.</p>

<p>Expandir e revisar andam juntos, pelo motivo da seção anterior. Capacidade de geração que a revisão não acompanha não vira entrega, vira fila.</p>

<p>Manutenção não some do backlog porque alguém finalmente entendeu que ela importa. Ela some quando deixa de depender disso.</p>]]></content><author><name>Aurélio Saraiva</name><email>aurelio.saraiva@creditas.com.br</email></author><category term="ia" /><category term="agentes-de-ia" /><category term="engenharia" /><category term="manutencao" /><category term="automacao" /><summary type="html"><![CDATA[Manutenção não fica para trás por falta de consciência: ela disputa capacity com o roadmap, e perde. Construí um agente que opera fora dessa disputa. Em quatro semanas ele entregou 224 PRs, com 99% do esforço em teste, correção, refatoração e segurança, e levou a cobertura de um serviço de 62% para 96,7%.]]></summary><media:thumbnail xmlns:media="http://search.yahoo.com/mrss/" url="https://aureliosaraiva.github.io/assets/img/posts/zelador-og.png" /><media:content medium="image" url="https://aureliosaraiva.github.io/assets/img/posts/zelador-og.png" xmlns:media="http://search.yahoo.com/mrss/" /></entry><entry><title type="html">RAG ou grafo de conhecimento? Depende do modelo, e isso muda a pergunta</title><link href="https://aureliosaraiva.github.io/blog/2026/09/rag-ou-grafo-de-conhecimento/" rel="alternate" type="text/html" title="RAG ou grafo de conhecimento? Depende do modelo, e isso muda a pergunta" /><published>2026-09-24T00:00:00+02:00</published><updated>2026-09-24T00:00:00+02:00</updated><id>https://aureliosaraiva.github.io/blog/2026/09/rag-ou-grafo-de-conhecimento</id><content type="html" xml:base="https://aureliosaraiva.github.io/blog/2026/09/rag-ou-grafo-de-conhecimento/"><![CDATA[<p><img src="/assets/img/posts/rag-vs-grafo-capa.png" alt="Documento fatiado à esquerda, grafo de conhecimento à direita: as duas estratégias comparadas no experimento" /></p>

<p><em>Publicado originalmente no <a href="https://www.linkedin.com/pulse/rag-ou-grafo-de-conhecimento-depende-do-modelo-e-isso-aur%C3%A9lio-saraiva-iyo3f/">LinkedIn</a> e no <a href="https://medium.com/@aureliosaraiva/rag-ou-grafo-de-conhecimento-medi-em-2-160-respostas-e-a-resposta-%C3%A9-desconfort%C3%A1vel-a734ec298777">Medium</a> em 24/09/2026.</em></p>

<p>Toda discussão sobre assistente técnico corporativo trava no mesmo ponto. Alguém
defende RAG, alguém defende grafo de conhecimento, e os dois lados têm argumentos
bons e nenhum número. Eu quis medir.</p>

<p>Montei um experimento controlado: dois enfoques, três famílias de modelo, três
repetições, 120 perguntas com gabarito. 2.160 respostas avaliadas por uma métrica
determinista e por um painel de três juízes.</p>

<p><strong>Minha tese, e ela é menos satisfatória do que eu queria:</strong> não existe vencedor
absoluto, o sinal inverte conforme o modelo gerador, e a variável de maior efeito
não é nenhuma das duas estratégias: é qual modelo você usa por trás.</p>

<p>Se você só tem cinco minutos, o resumo é este:</p>

<ul>
  <li>O grafo só venceu com significância estatística em <strong>um</strong> dos três modelos.</li>
  <li>O painel de juízes preferiu o RAG nos <strong>três</strong>.</li>
  <li>Trocar o modelo melhorou mais a qualidade do que trocar a estratégia.</li>
  <li>O dataset é sintético e o gabarito é meu. Isso limita o que você pode levar daqui.</li>
</ul>

<h2 id="o-que-este-experimento-mede-e-o-que-ele-não-mede">O que este experimento mede, e o que ele não mede</h2>

<p>Começo pelos limites, porque é o que decide se o resto vale a sua leitura.</p>

<p><strong>Mede:</strong> qual das duas estratégias de recuperação produz respostas mais corretas,
mais completas e mais rastreáveis sobre um ecossistema de microsserviços, com o
modelo gerador mantido constante dentro de cada comparação.</p>

<p><strong>Não mede:</strong> utilidade prática com desenvolvedores reais, custo de manutenção ao
longo do tempo, qualidade percebida por quem conhece o domínio, nem desempenho
sobre documentação de verdade, com suas inconsistências e seus buracos.</p>

<p><strong>E não mede o teto do grafo.</strong> A minha implementação é deliberadamente simples:
vizinhança de um salto, casamento difuso de entidade. Um grafo com consulta
multi-hop e agregação global responderia coisas que o meu não responde. Parte da
desvantagem que você vai ver nas tabelas é da implementação, não do paradigma.</p>

<h2 id="o-problema-que-você-provavelmente-tem">O problema, que você provavelmente tem</h2>

<p>Sua empresa migrou para microsserviços. Onde havia uma base de código que cabia
numa cabeça, agora há dezenas de serviços, contratos, eventos e bancos. O
conhecimento sobre isso existe, espalhado entre README, catálogo interno, board
de operação e três pessoas que sabem de cor.</p>

<p>As perguntas do dia a dia são banais e caras: <em>qual aplicação guarda dado
pessoal? quais são as dependências do serviço X? isso já existe, dá para
reusar?</em> Hoje a resposta é perguntar a alguém, ou ler documentação que pode estar
desatualizada. E o custo não é o tempo de busca, é a decisão técnica tomada
com informação velha.</p>

<p>Um assistente conversacional resolveria o acesso, desde que especializado no
domínio. E aí a literatura oferece dois caminhos.</p>

<p><strong>Não estruturado (RAG).</strong> Fatia a documentação, indexa em base vetorial,
recupera os trechos mais similares à pergunta e injeta no prompt. O termo foi
introduzido por <a href="https://arxiv.org/abs/2005.11401">Lewis et al. (2020)</a> e a
evolução recente está na <a href="https://arxiv.org/abs/2312.10997">survey de Gao et al.</a>.
Barato de manter, absorve mudança sem retreinar, fraco quando a resposta exige
raciocinar sobre relações explícitas.</p>

<p><strong>Estruturado (grafo de conhecimento).</strong> Modela o ecossistema como nós e arestas
tipadas: serviço, time, evento, banco, dependência. Consulta determinista e
rastreável, cara de modelar e de governar. A referência de base é <a href="https://doi.org/10.1145/3447772">Hogan et al.,
Knowledge Graphs</a>.</p>

<p>A convergência dos dois é o <a href="https://arxiv.org/abs/2404.16130">GraphRAG</a>, e é
para onde o resultado deste experimento aponta.</p>

<h2 id="a-regra-que-torna-a-comparação-válida">A regra que torna a comparação válida</h2>

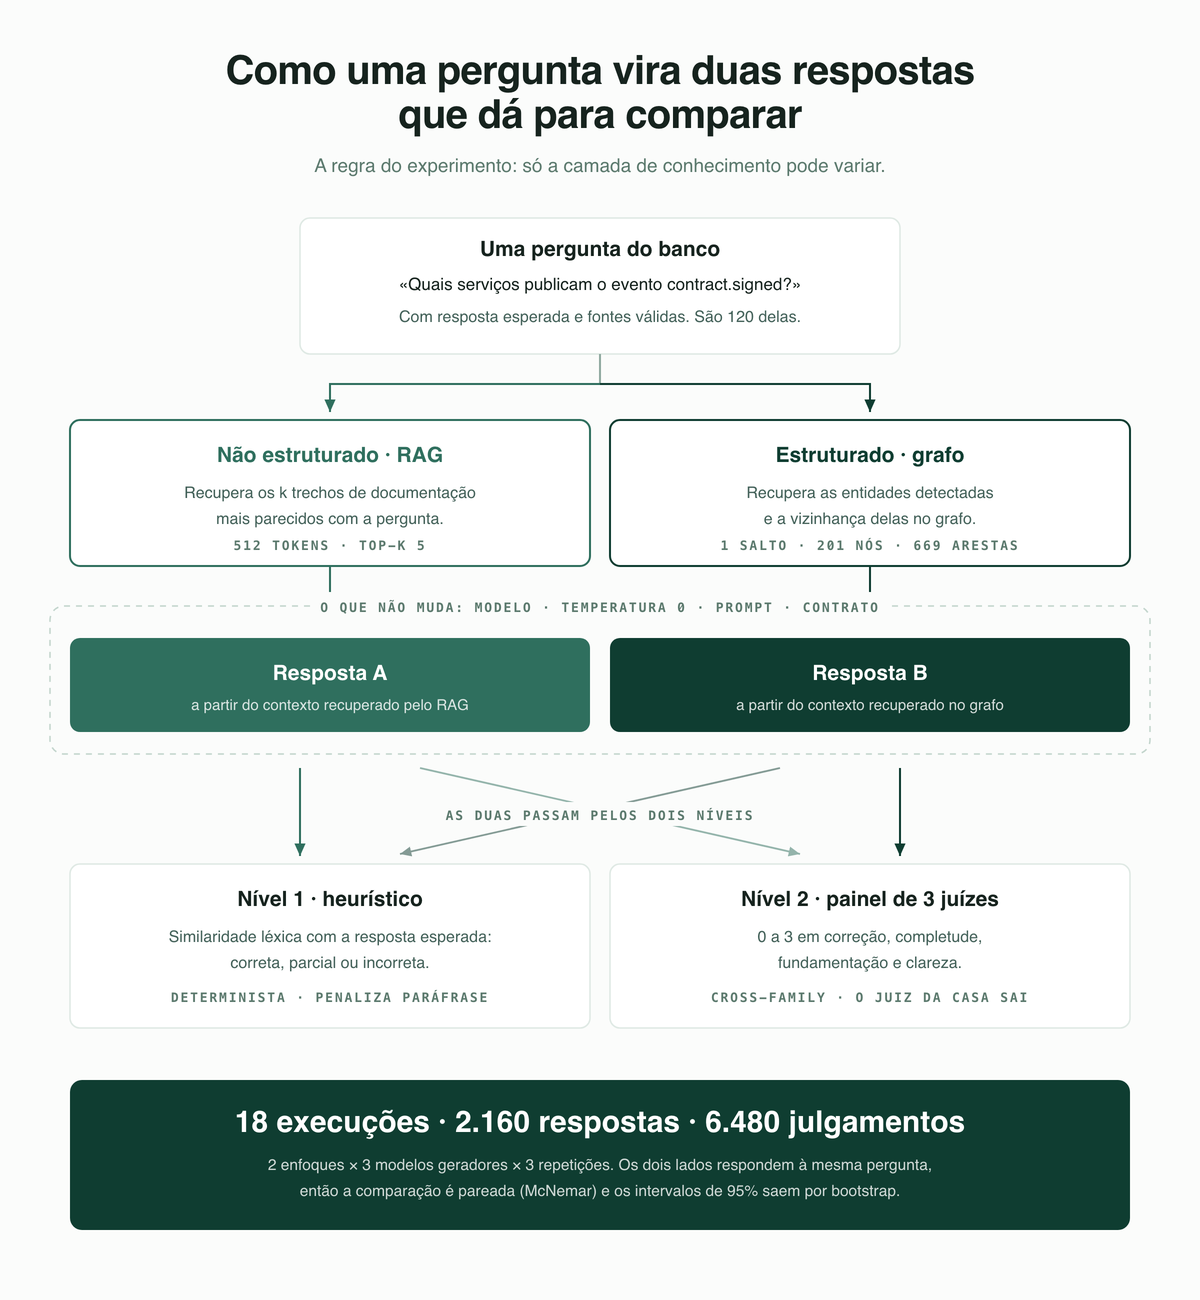
<p>A decisão mais importante veio antes de qualquer código: <strong>só a camada de
conhecimento pode variar.</strong></p>

<table>
  <thead>
    <tr>
      <th>Elemento</th>
      <th>Papel</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>Modelo, temperatura, prompts, contrato de resposta, avaliação</td>
      <td><strong>Constante</strong></td>
    </tr>
    <tr>
      <td>Camada de conhecimento e recuperação (documento × grafo)</td>
      <td><strong>Variável — o objeto de estudo</strong></td>
    </tr>
  </tbody>
</table>

<p><img src="/assets/img/posts/rag-vs-grafo-fluxo.png" alt="Diagrama do método: uma pergunta do banco segue por dois caminhos, RAG e grafo, gera duas respostas com o mesmo modelo, temperatura e prompt, e as duas passam pelos dois níveis de avaliação. 18 execuções, 2.160 respostas, 6.480 julgamentos." /></p>

<p>Sem esse princípio você compara duas implementações, não duas estratégias.
Qualquer diferença de prompt ou de formato de saída contamina o resultado de um
jeito que não dá para separar depois. É assim que quase todo benchmark
informal de RAG que circula por aí mede a habilidade de quem escreveu o prompt.</p>

<p>Os dois enfoques devolvem <strong>exatamente o mesmo contrato de resposta</strong>: pergunta,
enfoque, resposta, fontes, contexto recuperado, latência, custo estimado. É isso
que permite o código de avaliação, a API e a interface serem agnósticos.</p>

<h2 id="o-domínio-é-sintético-e-isso-foi-escolha">O domínio é sintético, e isso foi escolha</h2>

<p>Precisava de um ecossistema realista, publicável e reproduzível. Usar o da
empresa onde trabalho estava fora de questão. Então construí o CredityFlow, uma
fintech de crédito com garantia que não existe:</p>

<table>
  <thead>
    <tr>
      <th>Ativo</th>
      <th>Quantidade</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>Microsserviços</td>
      <td>52</td>
    </tr>
    <tr>
      <td>Eventos de domínio</td>
      <td>64</td>
    </tr>
    <tr>
      <td>Bancos de dados</td>
      <td>41</td>
    </tr>
    <tr>
      <td>Domínios / Times / Parceiros / Produtos</td>
      <td>15 / 15 / 8 / 6</td>
    </tr>
    <tr>
      <td>Nós do grafo / arestas</td>
      <td>201 / 669</td>
    </tr>
    <tr>
      <td>Documentos (lado não estruturado)</td>
      <td>117</td>
    </tr>
    <tr>
      <td>Perguntas do banco de avaliação</td>
      <td>120</td>
    </tr>
  </tbody>
</table>

<p>Ser sintético compra três coisas: eu controlo o conteúdo, sei qual é a resposta
certa de cada pergunta, e qualquer pessoa pode reexecutar sem depender de sistema
interno nenhum. E paga com validade externa, que é a limitação principal deste
trabalho e está declarada no fim.</p>

<p><strong>O mesmo conhecimento existe nas duas representações</strong>, com equivalência
garantida por regras de validação que rodam em integração contínua: se houver
referência quebrada, o dataset não é válido. Sem isso você acaba comparando um
lado que sabe mais que o outro, e nem percebe.</p>

<p>As 120 perguntas são rotuladas por categoria (factual, explicativa, impacto,
relacional, descoberta, ambígua), por dificuldade e por tipo de conhecimento,
cada uma com resposta esperada e fontes.</p>

<h2 id="os-parâmetros-dos-dois-lados">Os parâmetros dos dois lados</h2>

<p><strong>RAG:</strong> fragmentos de 512 tokens, sobreposição de 50, top-k 5, embeddings
<a href="https://huggingface.co/BAAI/bge-small-en-v1.5">BAAI/bge-small-en-v1.5</a> rodando
local, <a href="https://qdrant.tech">Qdrant</a> como base vetorial. A recuperação densa
segue o esquema popularizado por <a href="https://arxiv.org/abs/2004.04906">Karpukhin et al.
(DPR)</a>; a linhagem dos embeddings de sentença
vem de <a href="https://arxiv.org/abs/1908.10084">Sentence-BERT</a> e a família BGE está
descrita em <a href="https://arxiv.org/abs/2309.07597">C-Pack</a>.</p>

<p><strong>Grafo:</strong> <a href="https://networkx.org">NetworkX</a> em memória, construído a partir dos
arquivos de origem, então sempre consistente com o dado. Casamento difuso de
entidade com limiar 70/100, vizinhança de um salto.</p>

<h2 id="a-avaliação-tem-dois-níveis-porque-um-só-mente">A avaliação tem dois níveis porque um só mente</h2>

<p><strong>Nível 1, heurístico.</strong> Similaridade léxica, presença de entidades-chave,
cobertura de fontes. Barato, determinista, reproduzível. E superficial: penaliza
paráfrase, que é o defeito conhecido das métricas de sobreposição de n-gramas e a
razão de existirem alternativas semânticas como o
<a href="https://arxiv.org/abs/1904.09675">BERTScore</a>.</p>

<p><strong>Nível 2, painel de três juízes LLM</strong>, um de cada família, avaliando
correctness, completeness, groundedness e clarity de 0 a 3. O paradigma de
LLM-as-a-judge foi consolidado por <a href="https://arxiv.org/abs/2306.05685">Zheng et al.
(MT-Bench)</a>.</p>

<p>O detalhe que importa: <strong>a métrica de cabeceira é cross-family.</strong> Para cada
resposta, o juiz da mesma família do gerador é excluído do cálculo. Modelo
reconhece o próprio texto e o avalia melhor. <a href="https://arxiv.org/abs/2404.13076">Panickssery et al.
(2024)</a> mostram que a autopreferência está
ligada a essa capacidade de auto-reconhecimento. A única forma de neutralizar
isso é estruturalmente, nunca pedindo imparcialidade no prompt.</p>

<p>Significância por <strong>teste de McNemar pareado</strong>: as duas estratégias respondem
às mesmas perguntas, então o teste tem de ser pareado. Intervalos por bootstrap com
5.000 reamostragens, concordância entre juízes por kappa de Cohen.</p>

<h2 id="o-placar-e-a-inversão-que-ele-esconde">O placar, e a inversão que ele esconde</h2>

<p>Taxa de acerto estrita, só acerto pleno conta, n = 360 por célula:</p>

<table>
  <thead>
    <tr>
      <th>Gerador</th>
      <th>Estruturado</th>
      <th>RAG</th>
      <th>McNemar p</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>claude-sonnet-4-6</td>
      <td>0,200</td>
      <td>0,225</td>
      <td>0,380</td>
    </tr>
    <tr>
      <td>gpt-5.5</td>
      <td>0,361</td>
      <td>0,417</td>
      <td>0,103</td>
    </tr>
    <tr>
      <td>grok-build-0.1</td>
      <td><strong>0,411</strong></td>
      <td>0,294</td>
      <td><strong>&lt; 0,001</strong></td>
    </tr>
  </tbody>
</table>

<p>Duas leituras, e as duas importam.</p>

<p>A primeira: <strong>o sinal inverte conforme o modelo.</strong> O RAG vence com dois
geradores, o grafo vence com o terceiro, e só essa última diferença é
significativa. Se eu tivesse rodado o experimento com um modelo só, como faz
quase todo benchmark que a gente lê, teria publicado uma conclusão confiante e
errada, com intervalo de confiança e tudo. Nada no resultado apontaria para isso.</p>

<p>A segunda: <strong>a distância entre modelos é maior que a distância entre enfoques.</strong>
Ir do claude-sonnet-4-6 para o gpt-5.5 melhora mais do que trocar de estratégia
dentro de qualquer um deles. Isso rebaixa “RAG ou grafo?” a uma decisão de segunda ordem, e
é o achado transversal do trabalho.</p>

<h2 id="mude-a-definição-de-sucesso-e-o-sinal-muda-de-novo">Mude a definição de sucesso e o sinal muda de novo</h2>

<p>Repeti o teste com a definição ampla: acerto mais parcial, penalizando só o
erro rotundo. O resultado se inverte: o RAG passa a vencer com significância nos dois
primeiros modelos, e a vantagem do grafo no terceiro deixa de ser significativa.</p>

<p>A leitura é precisa: <strong>a virtude do RAG não é acertar mais. É errar menos feio.</strong></p>

<p>Quando a recuperação é parcial, ele responde incompleto. O grafo, quando o
casamento de entidade falha, responde errado com confiança. Para um assistente
interno essa distinção é tudo: resposta incompleta o desenvolvedor complementa,
resposta errada com fonte citada ele leva para a reunião.</p>

<h2 id="o-painel-discordou-da-métrica-dura-e-a-discordância-é-o-achado">O painel discordou da métrica dura, e a discordância é o achado</h2>

<table>
  <thead>
    <tr>
      <th>Célula</th>
      <th>Média do painel (0–3)</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>Estruturado / claude-sonnet-4-6</td>
      <td>2,13</td>
    </tr>
    <tr>
      <td>Estruturado / gpt-5.5</td>
      <td>2,23</td>
    </tr>
    <tr>
      <td>Estruturado / grok-build-0.1</td>
      <td>2,03</td>
    </tr>
    <tr>
      <td>RAG / claude-sonnet-4-6</td>
      <td>2,30</td>
    </tr>
    <tr>
      <td>RAG / gpt-5.5</td>
      <td><strong>2,45</strong></td>
    </tr>
    <tr>
      <td>RAG / grok-build-0.1</td>
      <td>2,28</td>
    </tr>
  </tbody>
</table>

<p>O painel prefere o RAG <strong>nos três modelos</strong>, incluindo aquele em que a heurística
dava vantagem estatisticamente significativa ao grafo.</p>

<p>Isso não é contradição, é instrumento. Um exemplo concreto: uma pergunta do banco
recebeu similaridade léxica de 0,25, foi classificada como <strong>incorreta</strong> pela
heurística e recebeu <strong>2,88 de 3</strong> do painel. A resposta estava certa, escrita com
outras palavras.</p>

<p>Métrica de n-grama mede vocabulário. Juiz LLM mede correção percebida, com viés.
Nenhuma das duas sozinha responde à pergunta, e quando elas discordam a
discordância aponta para onde olhar.</p>

<p>Uma honestidade sobre o painel: a concordância entre juízes foi apenas
<strong>moderada</strong>, kappa de Cohen entre 0,09 e 0,56. Painel de juízes LLM não é régua
de precisão. É segunda opinião estruturada, e frameworks como o
<a href="https://arxiv.org/abs/2309.15217">RAGAS</a> existem justamente porque avaliar
geração aumentada por recuperação continua sendo problema aberto.</p>

<h2 id="latência-e-custo">Latência e custo</h2>

<p>O RAG foi 12 a 20% mais rápido nos três modelos. Contexto de grafo é mais
compacto, mas a consulta tem uma etapa a mais.</p>

<p>Já o custo inverteu conforme o modelo: o grafo saiu mais barato com dois
geradores e mais caro com um. A composição de tokens de entrada e saída varia entre
provedores o suficiente para mudar o sinal, e eu reporto isso como observação, não
como conclusão: não fiz contrastação formal da composição de tokens.</p>

<h2 id="como-cada-um-falha">Como cada um falha</h2>

<p>É a parte mais útil do trabalho, e a que não aparece em tabela nenhuma.</p>

<p><strong>O grafo falha estruturalmente.</strong> Perguntei qual banco um serviço usa e ele
devolveu o identificador do nó, não o motor: o atributo não estava modelado. Em
“quantos times usam esta tecnologia?”, a vizinhança de um salto recupera dois
serviços e ele responde com confiança sobre dois. E se o casamento difuso erra a
entidade, o contexto inteiro está errado sem que nada indique isso.</p>

<p><strong>O RAG falha por incompletude.</strong> Identifica corretamente que um serviço usa
Redis, mas restringe a resposta ao serviço recuperado quando a pergunta pedia o
panorama.</p>

<p>Os dois erram, e erram coisas diferentes. <strong>São defeitos complementares.</strong> É
exatamente por isso que a direção óbvia é híbrida, com roteamento por tipo de
pergunta.</p>

<h2 id="o-que-eu-faria-na-sua-empresa">O que eu faria na sua empresa</h2>

<p><strong>Escolha o modelo primeiro.</strong> É a variável de maior efeito. Tratar isso como
detalhe de implementação e passar semanas ajustando tamanho de fragmento é
otimizar o parâmetro de segunda ordem.</p>

<p><strong>Comece por RAG.</strong> Piso melhor, manutenção mais barata, e o modo de falha é o
tolerável.</p>

<p><strong>Acrescente estrutura de forma cirúrgica:</strong> dependência, ownership, consumo de
evento. Não tente modelar o ecossistema inteiro antes de entregar qualquer coisa.</p>

<p><strong>Não confie numa métrica só.</strong> Uma heurística determinista e um painel de
famílias diferentes. Quando discordam, você achou um caso interessante, não um bug.</p>

<p><strong>Use teste pareado.</strong> As duas estratégias respondem às mesmas perguntas.
Comparar médias sem McNemar produz confiança que o dado não sustenta.</p>

<h2 id="as-limitações-ditas-em-voz-alta">As limitações, ditas em voz alta</h2>

<ul>
  <li><strong>O dataset é sintético e o gabarito é meu.</strong> Não houve validação com usuário
real. Compra controle e reprodutibilidade, paga em validade externa.</li>
  <li><strong>A implementação do grafo é deliberadamente simples.</strong> Parte da desvantagem em
agregação pode ser minha, não do paradigma.</li>
  <li><strong>Utilidade prática e manutenibilidade não foram medidas.</strong> Estavam nos
objetivos e ficaram qualitativas.</li>
  <li><strong>A heurística não foi validada contra julgamento humano.</strong> O painel mitiga,
não resolve.</li>
  <li>11 das 2.160 respostas (0,51%) foram erro de rede do provedor, não do sistema.</li>
</ul>

<h2 id="já-sei-o-que-vem-no-comentário">Já sei o que vem no comentário</h2>

<p><strong>“Em três meses esses modelos vão ser outros, e o seu placar não vale nada.”</strong>
Metade certa. O placar por célula envelhece, e é por isso que os nomes estão
escritos: para você saber exatamente o que expirou.</p>

<p>O que não envelhece é o resto. Se o sinal inverte conforme o gerador hoje, ele
inverte com a próxima geração também, e a conclusão de qualquer benchmark de um
modelo só continua sendo sorte. A distância entre modelos ser maior que a
distância entre estratégias é uma afirmação sobre a ordem de grandeza das
variáveis, não sobre estas três versões.</p>

<p><strong>“O seu grafo era fraco.”</strong> Provavelmente. Vizinhança de um salto e casamento
difuso são o piso do paradigma, e eu digo isso na segunda seção. O que isso
muda: o grafo tem mais teto a explorar do que este texto mostra. O que isso não
muda: o gerador continua pesando mais que a camada de recuperação, e essa parte
não depende da qualidade do meu grafo.</p>

<h2 id="conclusão-a-pergunta-estava-mal-colocada">Conclusão: a pergunta estava mal colocada</h2>

<p>Eu queria sair daqui com “use grafo” ou “use RAG”. O que o experimento devolveu é
que nenhuma das duas respostas existe sem antes dizer <em>com qual modelo</em>, e que a
variável que eu tratava como pano de fundo era a que mais pesava.</p>

<p>Isso é menos satisfatório e mais útil.</p>

<p>E vale além deste caso: <strong>benchmark com uma variável escondida não erra com
alarde, erra com intervalo de confiança.</strong> Antes de decidir arquitetura com base
num número, pergunte o que o experimento manteve constante, e se aquilo devia
mesmo estar constante.</p>

<h2 id="referências">Referências</h2>

<p>Tudo que este artigo afirma sobre trabalho de terceiro está aqui, com link para a
fonte primária. Os identificadores vieram das referências do meu TFM.</p>

<p><strong>Recuperação aumentada por geração</strong></p>

<ol>
  <li>Lewis, P. et al. (2020). <em>Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks</em>. <a href="https://arxiv.org/abs/2005.11401">arXiv:2005.11401</a></li>
  <li>Gao, Y. et al. (2023). <em>Retrieval-Augmented Generation for Large Language Models: A Survey</em>. <a href="https://arxiv.org/abs/2312.10997">arXiv:2312.10997</a></li>
  <li>Karpukhin, V. et al. (2020). <em>Dense Passage Retrieval for Open-Domain Question Answering</em>. <a href="https://arxiv.org/abs/2004.04906">arXiv:2004.04906</a></li>
  <li>Edge, D. et al. (2024). <em>From Local to Global: A Graph RAG Approach to Query-Focused Summarization</em>. <a href="https://arxiv.org/abs/2404.16130">arXiv:2404.16130</a></li>
</ol>

<p><strong>Conhecimento estruturado</strong></p>

<ol>
  <li>Hogan, A. et al. (2021). <em>Knowledge Graphs</em>. ACM Computing Surveys 54(4). <a href="https://doi.org/10.1145/3447772">doi:10.1145/3447772</a></li>
</ol>

<p><strong>Representação vetorial</strong></p>

<ol>
  <li>Reimers, N.; Gurevych, I. (2019). <em>Sentence-BERT: Sentence Embeddings using Siamese BERT-Networks</em>. <a href="https://arxiv.org/abs/1908.10084">arXiv:1908.10084</a></li>
  <li>Xiao, S. et al. (2023). <em>C-Pack: Packed Resources For General Chinese Embeddings</em>. <a href="https://arxiv.org/abs/2309.07597">arXiv:2309.07597</a></li>
  <li>BAAI. <em>bge-small-en-v1.5</em>. <a href="https://huggingface.co/BAAI/bge-small-en-v1.5">Hugging Face</a></li>
</ol>

<p><strong>Avaliação de geração</strong></p>

<ol>
  <li>Zheng, L. et al. (2023). <em>Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena</em>. <a href="https://arxiv.org/abs/2306.05685">arXiv:2306.05685</a></li>
  <li>Panickssery, A. et al. (2024). <em>LLM Evaluators Recognize and Favor Their Own Generations</em>. <a href="https://arxiv.org/abs/2404.13076">arXiv:2404.13076</a></li>
  <li>Zhang, T. et al. (2020). <em>BERTScore: Evaluating Text Generation with BERT</em>. <a href="https://arxiv.org/abs/1904.09675">arXiv:1904.09675</a></li>
  <li>Es, S. et al. (2023). <em>RAGAS: Automated Evaluation of Retrieval Augmented Generation</em>. <a href="https://arxiv.org/abs/2309.15217">arXiv:2309.15217</a></li>
</ol>

<p><strong>Método estatístico</strong></p>

<ol>
  <li>McNemar, Q. (1947). <em>Note on the sampling error of the difference between correlated proportions or percentages</em>. Psychometrika 12(2), 153–157. <a href="https://doi.org/10.1007/BF02295996">doi:10.1007/BF02295996</a></li>
  <li>Cohen, J. (1960). <em>A Coefficient of Agreement for Nominal Scales</em>. Educational and Psychological Measurement 20(1), 37–46. <a href="https://doi.org/10.1177/001316446002000104">doi:10.1177/001316446002000104</a></li>
  <li>Landis, J. R.; Koch, G. G. (1977). <em>The Measurement of Observer Agreement for Categorical Data</em>. Biometrics 33(1), 159–174. <a href="https://doi.org/10.2307/2529310">doi:10.2307/2529310</a></li>
  <li>Efron, B. (1979). <em>Bootstrap Methods: Another Look at the Jackknife</em>. The Annals of Statistics 7(1), 1–26. <a href="https://doi.org/10.1214/aos/1176344552">doi:10.1214/aos/1176344552</a></li>
</ol>

<p><strong>Ferramentas usadas no experimento</strong></p>

<ol>
  <li><a href="https://qdrant.tech">Qdrant</a> — base vetorial.</li>
  <li><a href="https://networkx.org">NetworkX</a> — grafo em memória.</li>
</ol>

<hr />

<p><em>Derivado do meu Trabajo Fin de Máster no Máster en Formación Permanente en
Inteligencia Artificial Aplicada da Universidad Europea de Madrid, orientado pelo
Dr. Jorge Moratalla Collado.</em></p>]]></content><author><name>Aurélio Saraiva</name><email>aurelio.saraiva@creditas.com.br</email></author><category term="ia" /><category term="rag" /><category term="grafos-de-conhecimento" /><category term="avaliacao-de-llm" /><category term="arquitetura" /><summary type="html"><![CDATA[Comparei RAG e grafo de conhecimento em 2.160 respostas, com três famílias de modelo. O vencedor muda conforme o modelo gerador, e essa é a variável que mais pesa.]]></summary><media:thumbnail xmlns:media="http://search.yahoo.com/mrss/" url="https://aureliosaraiva.github.io/assets/img/posts/rag-vs-grafo-og.png" /><media:content medium="image" url="https://aureliosaraiva.github.io/assets/img/posts/rag-vs-grafo-og.png" xmlns:media="http://search.yahoo.com/mrss/" /></entry></feed>